やさしい機械学習

Indeed における機械学習とは、we help people get jobsという私たちのミッションの鍵です。機械学習は、一日に掲載される何百万という求人情報を集め、分類し、分析することを可能にします。

この記事では、オープンソース化した Java ラッパーの特に便利な機械学習ライブラリについて説明し、どう皆さんに活用いただけるかを説明していきます。

機械学習における挑戦

機械学習システムを作り上げるのは容易ではありません。良いシステムには、いくつか正しくやらなければいけないことがあります。

  • 特徴量設計(Feature engineering) 例えば、テキストを特徴量ベクトルに変換するには、単語についての統計データを事前に計算しなければいけません。この工程には多くの課題が伴うこともあります。
  • モデルの品質 アルゴリズムのほとんどがハイパーパラメータのチューニングを必要としており、通常それらはグリッドサーチを通して行われます。この作業は何時間もかかりかねず、アイデアを素早く繰り返し試していく事を難しくします。
  • 大きなデータセットに向けたモデルの訓練 ほとんどのアルゴリズムの実装は、全てのデータセットがメモリに入ると想定します。Indeed で使用するような非常に大きなデータセットは、訓練が難しいのです。

うさぎが助けにやってきた
幸運なことに、そんな需要に応えてくれる素晴らしい機械学習システムがすでに存在します。Microsoft 社のコンピュータサイエンス研究者であるジョン・ラングフォード氏は、機械学習の理論とプログラミングの両方に突出した稀有な存在です。そんな彼のコマンドラインツールである Vowpal Wabbit (VW) は、一般化線形モデルのための最先端の技術を実装しており、柔軟なインプットデータフォーマットなど便利な機能を備えています。 VW は、機械学習のコミュニティで、沢山の注目を浴びており、業界内でも成功を収めています。

Vowpal Wabbit を使うメリット

Indeed では新しい求人情報の発見、検索結果の品質向上、そしてプロダクトのパフォーマンスの正確な測定などの作業を行うために、VW を使用してモデルを構築しています。VW が便利な理由は沢山あるのです。

メリットその1:あとで楽な入力フォーマット

VW にデータを投入するためには、まず特別なフォーマットにデータを変換する必要があります。このフォーマットは変な風に見えるかもしれませんが、沢山の利点があります。特徴量に名前空間 (namespace) を与える他には、一つの名前空間全体に重みをつけたり、特徴量に名前を付けたり、カテゴリーデータをそのままの形で渡したり、さらにはテキストさえも特徴量として渡すことができます。 VW を使用することで、下準備がほぼゼロの状態で生のテキストを渡して、それを踏まえきちんとしたモデルを訓練することができるのです!

また、このデータ・フォーマットはエラーが発生しにくくなります。予測の段階では、予測対象の特徴量を数値ベクトルではなく、このフォーマットに変換するだけで良いのです。

メリットその2:そのまま使えるパワフルな特徴量設計手法

Vowpal Wabbit のもう一つの強みは 特徴量設計手法が実装されている点です。これらの手法は、変数間の二次の相互作用(Quadratic interaction)や n-grams などのあまり複雑でないものから、変数間の二次の相互作用の低ランク近似(Low-rank quadratic approximation  factorization machines (FM) としても知られています)のように、より複雑なものまであります。これらの特徴量設計手法を全て、プログラムのオプションを変更するだけで使用できるようになるのです。

メリットその3:素晴らしい速さ

Vowpal Wabbit は最適化された C++ で書かれており、複数のプロセッサーコアを活用することができます。 VW は訓練時間だけを見ると R よりも2、3倍速く、また tf-idf の計算などの準備時間を見た場合 R よりも10倍速くなります。

メリットその4:データサイズにボトルネックなし

多くの機械学習アルゴリズムはメモリ内にデータセットを全て読み込まなければいけません。 VW は、オンライン学習という異なるアプローチを使用します。これは訓練集合をその事例ごとに読み込み、モデルを更新していきます。ハッシュトリックを使用しているので、メモリ内に単語から重みベクトルのインデックスへのマッピングを保存する必要はありません。メモリ内には重みベクトルさえあれば良いのです。これは一つのマシンでどんなサイズのデータセットからでもモデルを訓練ができるということです。データが何十GBあろうと問題ではありません。

VW APIを改善

Vowpal Wabbit は findのような古き良きUNIX コマンドラインツールにインスパイアされています。しかし Indeed では、わたしたちのインフラのほとんどが Java で書かれています。 Java コードから VW を起動したかったのですが、VWで提供されている Java ラッパーを使用した場合二つの問題に直面しました。

  • ラッパーが使用される全てのサーバーで、 boost  をインストールする必要がある
  • API のレベルがとても低いため、より便利である抽象化された操作の代わりに、文字列で操作する必要がある

これらの問題を解決するため、自社で VW 用のオープンソース JNI ラッパーを作りました。

プロジェクトに vw-wrapper を追加

以下に記したように、Maven を使用し vw-wrapper に依存性を追加します。他のソフトウェアは必要ありません。

<dependency>
   <groupId>com.indeed</groupId>
   <artifactId>vw-wrapper</artifactId>
   <version>1.0.0</version>
</dependency>

モデルを本番へデプロイ

以下三つの方法でモデルを本番にデプロイすることができます。

  • モデルをコマンドライン経由で訓練し、モデルを本番環境にコピーするか、ソースと一緒に Git に入れることで本番へデプロイする。
  • まず、あるコンポーネントがモデルを訓練し、ファイルに保存する。そのモデルを本番環境にコピーし、別のコンポーネントが予測を行う。
  • 訓練と予測を同一の Java プロセスの中で行う。これは、オンライン学習システム(新しいデータが利用可能になると継続してモデルを更新するシステム)を作りたい場合に有効。

わたしたちは、CentOS、Ubuntu、そして macOS と、自社で使用する三つの主要な環境でライブラリをテストしました。配布している jar ファイル には、共有ライブラリを含めています。

使用例

わたしたちは、 Java API の使用法を示す結合テストの中に、各モデルを再現しました。

  • MovieLens データセットのテストはユーザー評価の予測にどう VW を使用できるか示します。このテストは lrqfa のオプションを使用し、潜在的な(ユーザー、映画の)の反応からシグナルを取得します。これは factorization machines の論文にも述べられています。
  • Twitter のセンチメント分析のテストは 自然言語処理 にどう VW を使用できるか示しています。このテストは、特徴量として生のテキストを使う方法、n-grams を使う方法、そして  skip-n-grams の特徴量設計の手法を使う方法の三つの方法と、 featureMask  オプションを使用した特徴選択の行い方を示しています。

Vowpal Wabbit:名前の由来

Vowpal Wabbit という名前は、エルマー・ファッド風に Vorpal Rabbit を呼ぶところから取りました。 Vorpal というのはルイスキャロルのジャバウォックの詩に出てくるでたらめな言葉で、この文脈では“素早い”という意味で使われています。

One, two! One, two! And through and through
The vorpal blade went snicker-snack!
He left it dead, and with its head
He went galumphing back.

(訳)
一、二、一、二 ずんずんと 
素早い刃がざくざく刺した!
死体は残し 頭を持って
彼は意気揚々と戻っていった。

Vorpal Rabbit は非常に素早いうさぎなのです。

Vowpal Wabbit と Vowpal Wabbit Java を始めよう

VW について、更に詳しく知りたい方はラングフォード氏の VW ドキュメンテーションを読んでください。 VW の機能について書かれている他、チュートリアルや、内部で VW がどう動くか説明した論文へのリンクなども含まれています。

Github で私たちの作った Vowpal Wabbit Java ラッパー も是非チェックしてみてください。このラッパーの使いかたは、結合テストと Java API のドキュメンテーション を参照してください。便利なパラメータ についての情報も記載されています。
非同期メッセージの処理の遅延

Indeed では、求職者にとっての最善を常に考えています。求職者が仕事に応募する際には、採用される全てのチャンスを掴んで欲しいと考えています。企業の採用選考中に、Indeedに掲載された求人に対する応募書類が処理待ちだったせいで、仕事の機会を逃してしまうということは、求職者にとって受け入れがたいことなのです。Indeedの応募書類担当チームは、応募書類の処理時間のサービスレベル目標 ( service level objectives ) を管理しています。私たちは、応募書類の処理、そしてそのシステムの大規模化にあたって、改善策を常に考えているのです。

当初 Indeed では、自社のアグリゲーションエンジン内に RabbitMQ を取り込み、毎日処理する求人情報の量に対応していました。この成功を踏まえ、私たちは求職者からの応募書類を処理するパイプラインなどの他のシステムに RabbitMQ を組み込むことにしました。現在では、このパイプラインは一日に150万件以上の応募書類の処理を担当しています。その過程の中で、担当チームはこの組込に関して、以下に述べるようなresilience patterns(障害発生時の回復パターン)を複数実装する必要がありました。

  • メッセージが作られてから消費されるまでの追跡
  • 予期されたエラーが発生時のメッセージ処理の遅延 
  • 完全には処理することのできないメッセージをデッドレターキューに送信

遅延キューの実装

遅延キューは、一定の時間メッセージを取って置いておくことで、メッセージ処理を先延ばしてくれます。このパターンを実装した理由を理解する上で、多くのメッセージングシステムの複数の主要な挙動を、まず考える必要があります。Rabbit MQの特徴:

  • 最低一回 (at least once ) の送信を保証(一部のメッセージは複数回送信される可能性あり)
  • acknowledgement (ack) やnegative acknowledgement (nack) 、またはメッセージを再度キューに置くのを許可
  • 再度メッセージをキューに置く場合は、キューの終わりではなく先頭にメッセージを配置

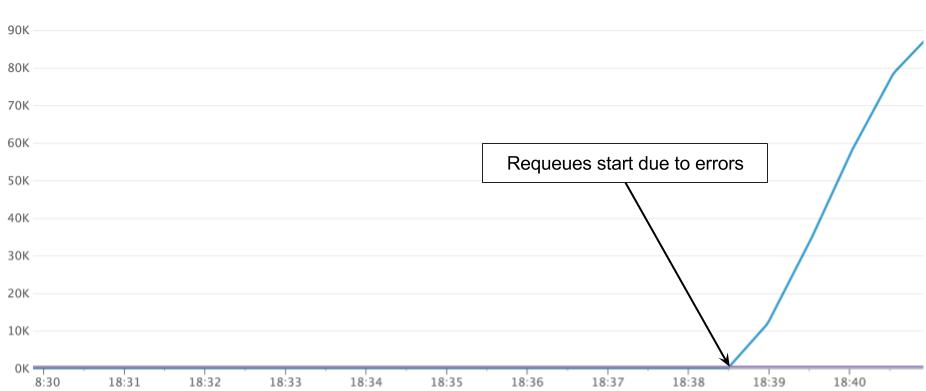
担当チームは、主に三番目の項目に対処するために遅延キュー (delay queue) を実装しました。Rabbit MQ がキューの先頭にメッセージを再度配置するので、コンシューマは直前に送信に失敗したメッセージを、おそらく次に処理することになります。これは、少量のメッセージしかない場合には問題にはなりませんが、処理不可能なメッセージの数がコンシューマスレッドの数を超えていくにつれ、重大な問題が発生します。コンシューマは、キューの先頭で処理不可能のメッセージのグループを通り抜けることができないため、クラスターの中にメッセージがたまっていってしまいます。

キューのサイズ
時間(24時間)

図1 クラスター内にたまっていくメッセージ

その仕組み

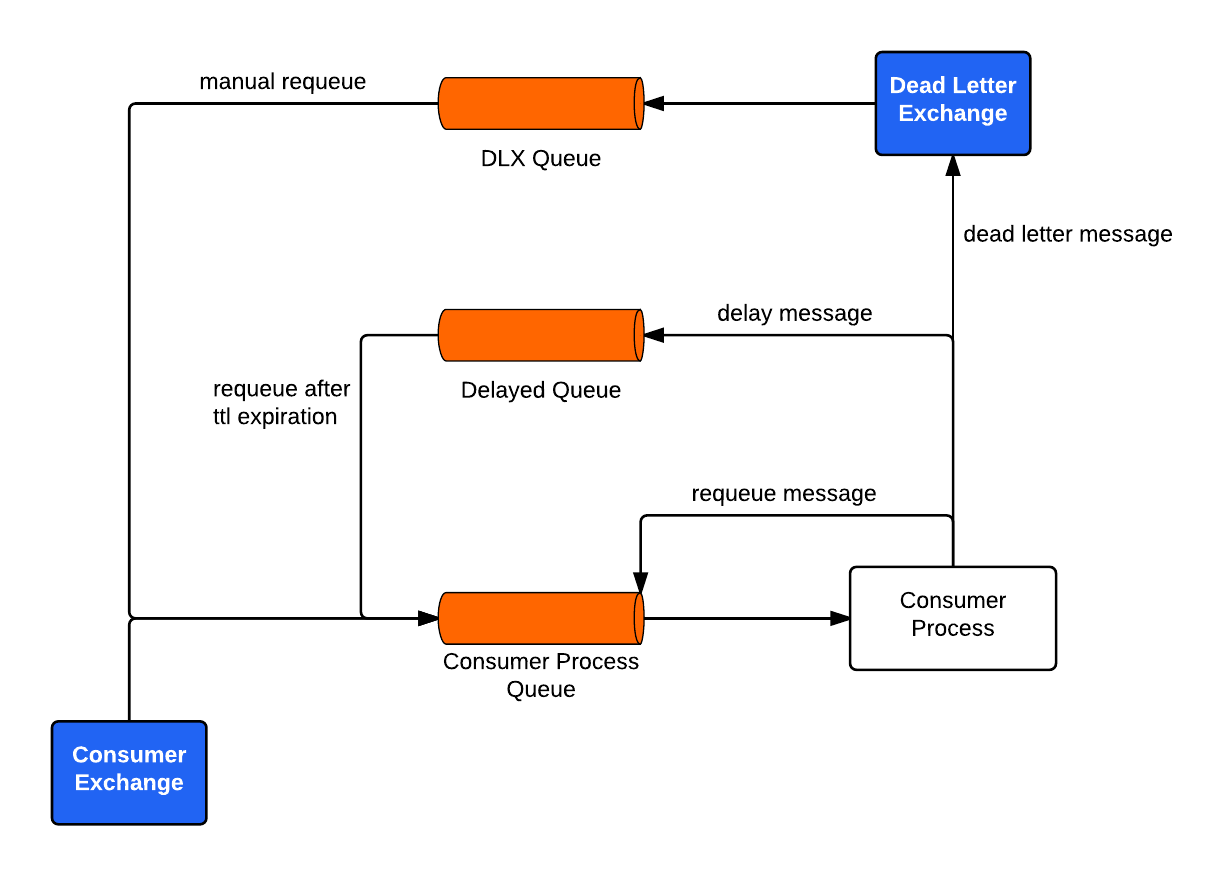
デッドレターキューなどのメカニズムはメッセージ処理の遅延を可能にする一方、システムを正常な状態に戻すために、そのメカニズムは、しばし人間による判断を必要とします。遅延キューのパターンはシステムが処理を続行できるようにします。くわえて、ファーストレスポンダー(就業時間内に本番環境の問題に即時対応するエンジニア)、サイト・リライアビリティ・エンジニア(SRE)、オペレーションチームの作業を減らしました。次の図は、エラーが発生した際のコンシューマ処理の選択肢を説明しています。

図2 非同期メッセージがコンシューマに渡っていくまでの仕組み

コンシューマがエラーにあい、メッセージを処理できない場合、エンジニアはコンシューマにそのメッセージを再度キューに置かせるか、遅延したキュー内に置かせるか、またはデッドレターキューに送信させるか選択する必要があります。その際、エンジニアは以下の項目を確認し、判断をします。

エラーは予期できたか?

システムに、再度発生することがなさそうな予期せぬエラーが発生した場合、メッセージは再度キューに置きます。こうすることで、システムがもう一度メッセージを処理できるようにします。再度メッセージをキューに置く作業は、以下のような状況で役立ちます。

  • サービスの通信中のネットワーク中断
  • トランザクションの取り消しや、ロックの取得に失敗することで起きるデータベースのオペレーションの不具合発生

依存するシステムは処理に追いつく時間を必要としているか?

再度処理実行前に少し時間をあける必要がありそうなエラーがシステムに発生した場合、メッセージを遅延させます。これはダウンストリームのシステムが回復できるようにするため、次にメッセージを処理しようとする際には、成功する可能性が高くなります。メッセージの遅延は以下のような状況に対応するのに便利です。

  • データベースの複製の際におきる時差の問題
  • 結果整合性(eventual consistency)が求められるシステムでの一貫性の問題

メッセージは処理不可能そうか?

もしメッセージが処理不可能な場合、デッドレターキューに送信します。それから、エンジニアは、メッセージを確認し、削除するか再度キューに手動で置く前に精査します。デッドレターキューは、システムが以下のような状況にある場合、役立ちます。

  • 不足している情報が含まれたメッセージを待っている
  • メッセージ再処理を試みる前に依存したリソースの人間による確認を必要している

エスカレーションポリシー

システムの障害発生時の回復力をさらに高めるため、エスカレーションポリシーを、1)エラーは予期できたか?2)依存するシステムは処理に追いつく時間を必要としているか?3)メッセージは処理不可能そうか?という前述の三つの選択肢の中で設定するのも良いでしょう。Indeedでは以下のように対応しました。

  • システムがキューにn回メッセージを置き直したら、そのメッセージを遅延させる。
  • もしこのメッセージがさらにm回遅延されたら、デッドレターキューに送る。

こういった種類のポリシーを持つことで、ファーストレスポンダー、SRE、オペレーションチームの作業を削減しました。日々、さらに増え続ける候補者の応募書類を処理する中で、私たちはその処理システムを拡張することができました。

Indeed におけるリリース工程の自動化

Indeed が急成長する中で、沢山の課題が生まれましたが、中でも特にリリース工程は、取り組みがいのあるものでした。ほぼ手動の工程はスケールできず、ボトルネックとなってしまいました。なので、私たちは独自のソリューションの開発を決めました。私たちが工程を自動化するなかで学んだ教訓は、ソフトウェアの質と開発者の善意を保っていきたいと考える、他の急成長中の組織も応用できるものとなりました。

私たちが辿った道のり

私たちのソフトウェアリリースの工程は、以下のように四つの主な目標があります。

  • どの機能がリリースされるのか理解していること
  • プロダクト間、チーム間での依存性について理解していること
  • リリース候補の中にあるバグを素早く修正すること
  • 追跡、分析、反復利用を可能にするため、リリースの詳細を記録すること:

そして、私たちの工程は最終的には以下のようになりました。

この工程は分かりやすかったのですが、多くの作業を必要としました。どんな状況だったかと言うと、4 件の新規機能を持つ 1 件のソフトウェアリリースに対し、100 回分のクリックと Git のアクションが必要でした。1 件の新規機能につき、およそ 13 回分のアクションが工程に追加されました。

こうした工程の確認を通して、私たちは、4つの主な問題を見つけ出しました。

  • リリース管理に時間がかかりすぎた
  • リリースの中身が正確には何なのかを理解しにくかった
  • 手動のステップが多すぎたため、エラーが発生する可能性が高かった
  • リリースをきちんと扱える知識を持つのはシニアマネージャーだけに限られていた

そうして、私たちは気づきました。自動化がもっと必要だ、と。

単純化すれば良いじゃない?

もちろん、工程を自動化するよりも、ただ単純化することもできました。しかし、私たちのもつ工程は、無くしたくない二次的な利益がありました。

データ 工程が与えてくれる多くのデータと指標のおかげで、継続して改善を重ねることが可能

履歴 工程があるので、何がいつリリースされたかを追跡することが可能

透明性 複雑ではあるものの、工程のおかげで各ステップを検証することが可能

自動化までの道

私たちは、工程の多くを自動化し、オーバーヘッドを減らせることに気づきました。そのために、既にあるソリューションをもっと上手に、賢くまとめる必要がありました。

私たちの工程は、以下の複数のシステムを使用しています。

  • Atlassian JIRA: 課題管理と追跡
  • Atlassian Crucible:  コードのレビュー
  • Jenkins: リリース候補のビルドとデプロイ
  • Gitlab:  ソース管理
  • 様々なビルドや依存性の管理ツール

これらのツールを置き換える代わりに、これらツールが各自コミュニケーションをとれるように、統一されたリリースシステムを作り上げることにしました。この統一したリリースシステムを、管制塔を意味する
Control Tower  (コントロールタワー) と呼ぶことにしました。

[slideshow_deploy id=’2158′]

Control Tower の機能を表すスライドショー

依存性の管理ツールとの統合によって、リリースマネージャー(RM)がライブラリ・アップデートを通して入ってくる新しいコードの追跡を出来るようになりました。RM は素早くコードの相互依存性を評価し、リリース内の変更の進捗を確認することができます。最後に、RM が全て確認した後、 Jenkins を通してビルドの実行が可能になります。

Control Tower のメイン画面からは、RM が全ての関連システムの詳細を確認することができます。変更は JIRA のイシューによってまとめられ、各変更項目はCrucible のコードレビュー情報と Git のレポジトリ・ロケーションのリンクを含んでいます。

自動化することで、リリース工程の中で必要だった人間同士のやりとりを劇的に減らしました。以下の画像は、グレイの色がついたボックスそれぞれが、削除された手動のステップを表しています。

自動化をすすめた後では、必要なクリックや Git のアクションの回数を、100 回以上から、15 回未満まで減らしました。新規機能を追加するのも、13 回のアクションを必要とするだけで、余分な仕事を増やすことがなくなりました。

Control Tower に興味を持った方は、是非 Indeed Eng テックトークをご覧下さい。Control Tower について、32:45 ごろから説明しています。

私たちが学んだこと

統一されたリリースシステムを作り上げる過程で、私たちはいくつか大切なことを学びました

教訓その1:
自動化すべきは欲しい工程でなく、既にある工程

私たちが最初にリリース工程の自動化に着手した時、私たちは、ついエンジニアがそういう状況でしてしまうことをしました。それは、始める前に、工程を可能な限り理解できるように、工程を学ぶ、ということでした。それから、またエンジニアがやりがちなことですが、それを改善しようとしました。

自動化を進める中で工程を修正する、ことは当然です。けれど、例え問題があったとしても既にテスト済みの稼働する工程のほうが、格好よく見えるテストされてない工程よりも好ましい、と言うことを私たちは学びました。自動化の最初の試みは、開発者たちが新しいやり方に馴染みがなかったので、反発を受けました。

教訓その2:
自動化は想像以上に有意義である

多くの人が工程を「自動化」と聞くと、人間による意思決定を削除して、設定したら後は忘れてしまうようなものだと考えがちです。しかし、場合によっては工程から人間のやりとりを削除できないこともあります。技術的に難しすぎる場合や、正しい結果になるのをきちんと確かめるために、人間の目でチェックしたい場合もあります。そういった状況でも、自動化が役立つのです。

場合によっては、自動化はデータを集めて表示し、人間が決断を下すスピードを上げてくれるのです。何かを選択する際に人間の手が必要な際にも、より良いデータを提供することで、さらなる情報に基づいた決断を下しやすくなる、ということに私たちは気づきました。

人間と機械のアクションの適切なバランスを決めるのは、自動化にとっての鍵となります。機械学習の技術を取り入れることで、人間による意思決定をさらに加速させるような改善も、将来行えるようになるでしょう。

教訓その3:
何がなんでも透明性が大事

エンジニアは、非効率なものを好みませんが、謎も同様に嫌います。「何故」「どうやって」などの洞察を与えることなく、全て行ってしまう、ブラックボックス化した工程は避けたいと考えました。

私たちは、できる限りログを取り、メッセージを使用して、十分な透明性を提供しています。どんな工程が実行されたか、そして何故それが実行されたかを、開発者が検証できるようにすることで、彼らが自動化のソリューションを信頼し、受け入れやすくしました。また、ログは、何か不具合が発生するようなことがあれば役立ちます。

そして、これから

新しいシステムの環境が整ったとはいえ、私たちは、これすらも改善できると考えています。次なるステップも、密かに取り組んでいるところです。

課題のステータス、完了したコードレビュー、ビルド/テストのステータス、そしてその他の外部の要素を監視できるアルゴリズムを、現在私たちは開発しています。リリースの準備ができた機能を、プログラムで理解することができるシステムを開発できるのです。そして、自動で適切なマージリクエストを作成し、リリース工程を進める事ができるのです。これは、さらに機能の作成と本番に送り出すまでの時間を削減してくれます。

機械学習の技術を利用して、意思決定のプロセスで使用する膨大な量のデータを取り込むことができます。これはリスキーなデプロイを指摘し、さらにテストに時間を費やすべきか、最小の監視だけでデプロイが可能かどうかを教えてくれるのです。

私たちのリリース管理システムは、顧客が望む品質を維持しながら、ソフトウェアのアウトプットを増やすための、重要なステップです。このシステムは、あくまでステップであり、最終的なゴールではありません。継続して工程を改善していくことで、そして進んで行く中で学ぶことで、私たちは、「さらに多くの求職者と仕事の橋渡しをする」という、最終的なゴールを目指しているのです。